Техническое обслуживание серверов: что проверять и как часто
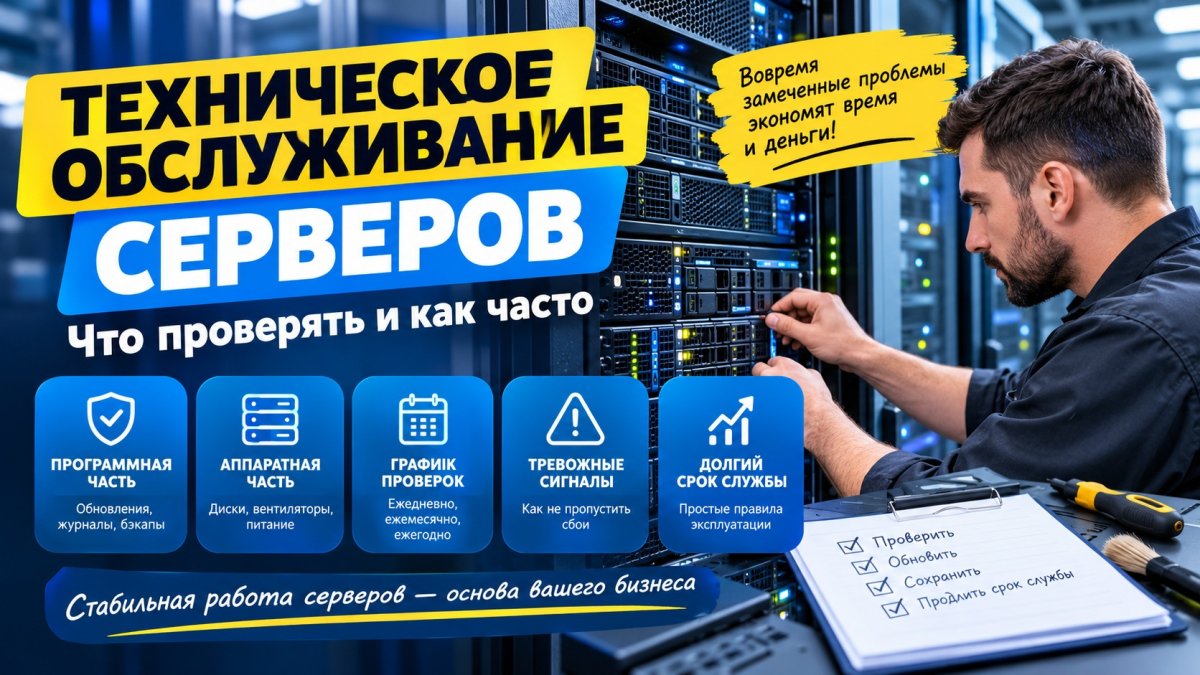
Сервер редко выходит из строя внезапно: перед аварией почти всегда есть признаки вроде растущих ошибок диска, перегрева или забитых пылью радиаторов. Если их вовремя заметить, замена детали занимает час, а не несколько дней простоя всей компании. Особенно это важно для серверов с 1С и файловыми хранилищами, где остановка работы сразу бьёт по бухгалтерии и складу. Ниже разберём, какие работы нужны сервису регулярно и что можно делать самостоятельно.
Оглавление
- Обслуживание серверов
- Техническое обслуживание серверов
- Как составить график обслуживания сервера
- Какие показатели считать тревожными
- Типичные ошибки при обслуживании
- Как продлить срок службы серверного оборудования
- Частые вопросы об обслуживании серверов
- Как часто нужно проводить обслуживание сервера?
- Сколько служит серверное оборудование?
- Что опаснее для сервера: пыль или перегрев?
- Можно ли обслуживать сервер без штатного администратора?
- Как понять, что диск скоро выйдет из строя?
- Почему важна проверка восстановления из резервной копии?
- Какая температура считается нормальной для серверной?
- Нужен ли ИБП для сервера и как его обслуживать?
- Какие данные нужно хранить в журнале обслуживания?
- Что делать, если сервер с 1С начал работать медленнее?
Обслуживание серверов
Обслуживание серверов делится на программную и аппаратную части, и пропускать нельзя ни одну. Программная часть включает установку обновлений безопасности, контроль работы служб, проверку журналов событий и свободного места на дисках. Раздел, заполненный больше чем на 85%, работает заметно медленнее, а на системном диске это приводит к сбоям.
Не менее важно резервное копирование: следите, чтобы копии создавались по расписанию, хранились отдельно от сервера и хотя бы раз в квартал проверялись восстановлением на тестовой машине. Настройте уведомления на почту, чтобы узнавать о проблемах раньше пользователей. Раз в месяц проверяйте учётные записи и права доступа: уволенные сотрудники не должны сохранять доступ к данным.
Копия, которую ни разу не разворачивали, остаётся предположением, а не гарантией.
Техническое обслуживание серверов
Техническое обслуживание серверов касается самого оборудования и выполняется по графику. Раз в неделю проверяйте состояние RAID-массива и SMART-показатели дисков: именно отказ диска остаётся самой частой причиной потери данных. Раз в полгода-год очищайте корпус от пыли сухим сжатым воздухом, не касаясь компонентов руками без антистатической защиты, и проверяйте работу вентиляторов и температуру процессоров.
Следите за журналом контроллера управления (IPMI, iDRAC, iLO): он фиксирует ошибки памяти, перегрев и сбои блоков питания, которых не видно в операционной системе. Проверяйте ИБП и состояние его аккумуляторов, обычно их меняют раз в 3–5 лет. Убедитесь, что серверная проветривается, а температура в ней не превышает 25–27 °C. Заранее планируйте замену дисков и блоков питания по сроку службы, не дожидаясь отказа.
Серьёзные работы, например замену комплектующих или обновление прошивок BIOS и RAID-контроллера, проводите в согласованное окно, предварительно сделав резервную копию. Ведите журнал выполненных работ: он помогает увидеть закономерности и быстрее найти причину повторяющихся сбоев.
Если в штате нет администратора, регулярные работы можно передать специалистам SkyComp в Челябинске. Мы проверим состояние оборудования, настроим мониторинг и возьмём сервер на сопровождение без остановки работы сотрудников. Работаем с юридическими лицами и бюджетными учреждениями, оплата по факту работ. Консультация по телефону бесплатна: +7 (932) 300-50-51.
Как составить график обслуживания сервера
Хороший график строится на трёх уровнях: что проверять ежедневно, что раз в месяц и что раз в год. Такой подход не перегружает администратора и закрывает основные риски.
Ежедневно (5-10 минут). Просмотрите уведомления системы мониторинга, статус последних резервных копий и критические записи в журналах событий. Если автоматических оповещений нет, достаточно беглого взгляда на загрузку процессора, памяти и свободное место на дисках.
Ежемесячно. Установите обновления безопасности после проверки на тестовой машине, проанализируйте динамику заполнения хранилища, пересмотрите список пользователей и прав доступа. Хорошая практика - сравнить текущие показатели нагрузки с прошлым месяцем: плавный рост говорит о необходимости планировать расширение ресурсов.
Раз в год. Проведите полный аудит: оцените износ дисков и аккумуляторов ИБП, актуальность версий прошивок, соответствие мощности сервера растущему числу пользователей и баз данных. Тогда же стоит пересмотреть план аварийного восстановления и убедиться, что он реально выполним.
Какие показатели считать тревожными
Некоторые сигналы требуют реакции в тот же день, не откладывая на плановое окно:
- рост числа переназначенных или нестабильных секторов на диске в SMART;
- деградация RAID-массива или перестроение без видимой причины;
- регулярные ошибки памяти в журнале IPMI;
- шум вентиляторов, нехарактерный для обычной работы, и рост температуры процессора под привычной нагрузкой;
- перезагрузки без записи о причине в журнале системы;
- предупреждения ИБП о снижении ёмкости аккумуляторов.
Типичные ошибки при обслуживании
- Резервные копии без проверки восстановления. Копия, которую ни разу не разворачивали, остаётся предположением, а не гарантией.
- Хранение бэкапов на том же сервере. При аппаратной аварии, пожаре или шифровальщике пропадает и оригинал, и копия.
- Обновление прошивок «на ходу». Сбой в процессе обновления BIOS или RAID-контроллера может вывести оборудование из строя.
- Отсутствие журнала работ. Без записей невозможно понять, после каких изменений начались сбои.
- Игнорирование предупреждений. Многие отказы сопровождаются предупреждающими сообщениями за недели до аварии.
Как продлить срок службы серверного оборудования
Срок жизни сервера напрямую зависит от условий эксплуатации. Стабильная температура, чистый воздух, исправное электропитание с фильтрацией и нормальная вентиляция серверной продлевают работу комплектующих на годы. Жёсткие диски лучше менять по расписанию, ориентируясь на наработку, а не на первые симптомы. Блоки питания в резервируемых конфигурациях стоит заменять парами, чтобы износ был равномерным.
Частые вопросы об обслуживании серверов
Как часто нужно проводить обслуживание сервера?
Состояние дисков и RAID проверяют еженедельно, программные обновления и права доступа - раз в месяц, чистку от пыли и осмотр вентиляторов - раз в 6-12 месяцев. Для серверов с критичными данными интервалы лучше сокращать.
Сколько служит серверное оборудование?
В среднем сервер эксплуатируют 5-7 лет. Диски обычно меняют через 3-5 лет работы, аккумуляторы ИБП - через 3-5 лет, блоки питания и вентиляторы служат дольше, но требуют контроля.
Что опаснее для сервера: пыль или перегрев?
Эти проблемы связаны: пыль забивает радиаторы и ухудшает охлаждение, из-за чего растёт температура. Постоянный перегрев ускоряет износ процессора, памяти и дисков, поэтому бороться нужно с причиной и следствием одновременно.
Можно ли обслуживать сервер без штатного администратора?
Да, если настроен автоматический мониторинг с уведомлениями и есть чёткий регламент. Базовые проверки можно выполнять по чек-листу, а сложные работы, такие как замена комплектующих и обновление прошивок, лучше поручать квалифицированным специалистам.
Как понять, что диск скоро выйдет из строя?
Основные признаки: рост числа переназначенных секторов в SMART, замедление чтения и записи, щелчки или посторонний шум, ошибки файловой системы, предупреждения RAID-контроллера. При появлении любого из них нужно сделать резервную копию и подготовить замену.
Почему важна проверка восстановления из резервной копии?
Копия может создаваться с ошибками, быть неполной или повреждённой. Только пробное восстановление на тестовой машине подтверждает, что данные можно вернуть, а также показывает, сколько времени займёт процесс в реальной аварии.
Какая температура считается нормальной для серверной?
Оптимальный диапазон - 18-25 °C, допустимо до 27 °C. Важна и стабильность: резкие перепады вредят оборудованию не меньше, чем стабильно высокая температура. Также следите за влажностью: комфортный уровень составляет 40-60%.
Нужен ли ИБП для сервера и как его обслуживать?
Да, ИБП защищает от скачков напряжения и позволяет корректно завершить работу при отключении электричества. Раз в несколько месяцев проверяйте его под нагрузкой, следите за состоянием аккумуляторов и меняйте их по сроку службы.
Какие данные нужно хранить в журнале обслуживания?
Дату и характер работ, версии прошивок и обновлений, замену комплектующих, показатели SMART и температуры на момент проверки, выявленные проблемы и принятые меры. Такой журнал ускоряет диагностику повторных сбоев.
Что делать, если сервер с 1С начал работать медленнее?
Проверьте загрузку процессора и памяти, свободное место на дисках, состояние RAID и фрагментацию баз. Часто причина в переполненном разделе, устаревшей индексации или накопившихся фоновых процессах. Если причина не найдена, проанализируйте журналы и динамику нагрузки за последние недели.
- Статью добавил пользователь
- Категория
- Дата размещения 23.10.2026, просмотров 53

Администрация сайта не несет ответственности за содержимое объявлений.
СЛАНДО PRO — ПОРТАЛ ОБЪЯВЛЕНИЙ И УСЛУГ
SLANDO PRO — современная доска объявлений и универсальный портал для поиска товаров, услуг, недвижимости и вакансий. Публикуйте объявления бесплатно и находите нужное легко! Подходит для частных лиц и бизнеса в России, Украине и других странах СНГ.

