Наблюдаемость ИТ-инфраструктуры: почему бизнесу уже недостаточно обычного мониторинга
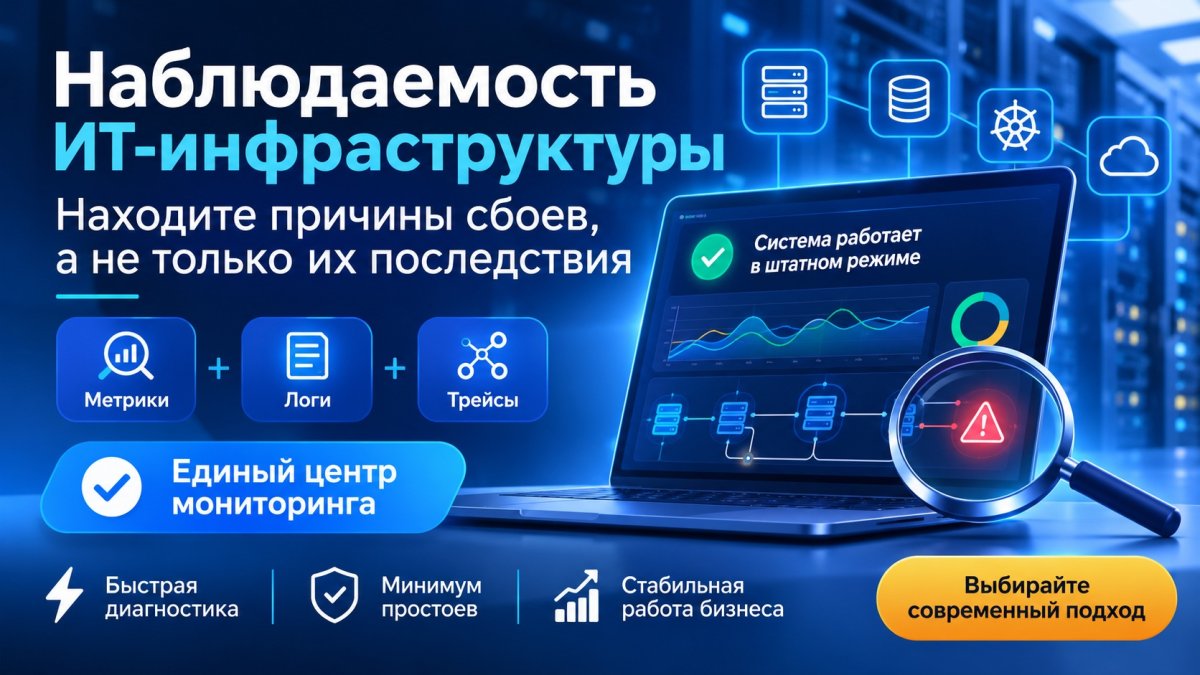
Наблюдаемость ИТ-инфраструктуры помогает находить причины сбоев, а не только фиксировать их последствия. Обычный мониторинг сообщает, что сервис недоступен, а наблюдаемость объясняет, почему это произошло и какие процессы затронуты. Для компаний, чей бизнес зависит от цифровых сервисов, этот подход становится способом сохранить непрерывность работы.
Оглавление
Почему обычного мониторинга становится недостаточно
Современная компания редко работает на одном сервере. Приложение обращается к базе данных, та связана с хранилищем, запросы проходят через балансировщики, контейнеры и облачные сервисы. Классический мониторинг следит за отдельными показателями: загрузкой процессора, свободным местом на диске, доступностью узла. Каждый из них может быть в норме, а клиент при этом не сможет оформить заказ.
Причина сбоя часто находится не там, где он проявился. Медленная страница оплаты бывает следствием перегруженной очереди сообщений или неудачного обновления соседнего сервиса. Специалистам приходится вручную сопоставлять данные из нескольких систем, и поиск первопричины растягивается на часы.
Что такое наблюдаемость ИТ-инфраструктуры
Наблюдаемость (observability) — это способность понять внутреннее состояние системы по данным, которые она отдаёт наружу. Мониторинг отвечает на вопрос «что сломалось», а наблюдаемость помогает выяснить, почему и в каком именно месте.
На чём строится наблюдаемость
Обычно используют три типа телеметрии:
- метрики — числовые показатели во времени: нагрузка, время отклика, число ошибок;
- журналы событий (логи) — подробные записи о том, что происходило в системе;
- трассировки — путь отдельного запроса через все сервисы с указанием мест задержки.
Главная ценность возникает при совместном анализе. Метрика сигнализирует об отклонении, лог раскрывает детали, а трассировка указывает на проблемный участок.
Мониторинг и наблюдаемость: в чём разница
|
Критерий |
Мониторинг |
Наблюдаемость |
|---|---|---|
|
Подход |
Заранее заданные проверки |
Анализ совокупности данных |
|
Ключевой вопрос |
Что произошло? |
Почему это произошло? |
|
Неизвестные сбои |
Часто остаются незамеченными |
Можно исследовать без заготовленных правил |
|
Область контроля |
Отдельные компоненты |
Связи между компонентами |
Зачем бизнесу единая система наблюдения
Единая система собирает данные со всех уровней инфраструктуры и показывает их в одном контексте. По мере роста цифровой среды компаниям сложнее отслеживать состояние технических компонентов отдельными инструментами: серверы, сетевое оборудование, базы данных и приложения работают независимо, но остаются частями одной системы. Поэтому всё чаще применяется платформа для наблюдаемости ИТ-инфраструктуры, которая объединяет сбор и анализ технических данных и позволяет быстрее выявлять причины возникающих сбоев.
Практическая польза для бизнеса складывается из нескольких эффектов:
- сокращается время диагностики, потому что данные не нужно собирать вручную;
- снижается риск простоев, так как тренды показывают деградацию до отказа;
- уведомления автоматически уходят ответственным специалистам;
- руководитель видит связь технических показателей с работой клиентских сервисов.
Важно! Ценность наблюдаемости определяется не количеством графиков, а скоростью, с которой команда понимает причину проблемы.
Какие компоненты необходимо контролировать
Набор зависит от архитектуры компании, но базовый перечень обычно включает:
- серверы и операционные системы;
- сетевое оборудование и каналы связи;
- базы данных и системы хранения;
- виртуальные машины и гипервизоры;
- контейнеры и средства оркестрации;
- бизнес-приложения, интеграции и API.
Как выбрать инструменты для наблюдаемости
Перед покупкой стоит проверить решение по ключевым критериям:
- Масштабируемость. Система должна выдерживать рост числа узлов и объёма данных.
- Интеграции. Важна поддержка открытых стандартов, например OpenTelemetry, и готовых коннекторов.
- Безопасность. Нужны разграничение доступа и возможность хранить данные на собственной площадке.
- Отказоустойчивость. Сама система наблюдения не должна становиться единой точкой отказа.
- Удобство интерфейса. Дашборды должны быть понятны и администратору, и руководителю.
Совет эксперта. Начните с пилота на одном критичном сервисе: так проще оценить пользу и определить, какие данные действительно нужны.
Перспективы развития наблюдаемости
Системы наблюдения движутся к автоматизации: аналитика на основе машинного обучения выявляет аномалии и предлагает вероятную причину сбоя. Рост облачных технологий и контейнеризации усложняет архитектуру, поэтому спрос на сквозную видимость будет расти. Отдельное внимание компании уделяют отечественным программным решениям, которые проще встроить в требования по безопасности и импортозамещению.
Вопросы и ответы
Чем наблюдаемость ИТ-инфраструктуры отличается от обычного мониторинга?
Мониторинг отслеживает заранее определённые показатели и события. Наблюдаемость анализирует совокупность данных, чтобы глубже понимать состояние системы и находить причины проблем.
Какие данные используются для наблюдаемости ИТ-систем?
Основные источники — метрики, журналы событий (логи) и трассировки. Их совместный анализ помогает оценивать производительность и выявлять неисправности.
Какие компоненты инфраструктуры нуждаются в постоянном контроле?
В зависимости от архитектуры это серверы, сетевое оборудование, базы данных, виртуальные машины, контейнеры и бизнес-приложения.
Как наблюдаемость помогает сократить простои?
Своевременное обнаружение отклонений позволяет быстрее найти источник неисправности и уведомить ответственных. Время диагностики сокращается.
Подходит ли комплексный мониторинг небольшим компаниям?
Да. Масштаб системы можно подобрать под размер инфраструктуры, учитывая планы роста компании.
Заключение
Усложнение ИТ-среды делает точечный мониторинг недостаточным: компании нужен сквозной взгляд на сервисы и связи между ними. Наблюдаемость сокращает время поиска причин сбоев и снижает риск простоев. Выбирать инструменты стоит по масштабируемости, интеграциям, безопасности и отказоустойчивости. Надёжность инфраструктуры напрямую влияет на непрерывность бизнес-процессов, и именно с этой позиции стоит оценивать вложения в наблюдаемость.
- Статью добавил пользователь
- Категория
- Дата размещения 01.11.2026, просмотров 50



Администрация сайта не несет ответственности за содержимое объявлений.
СЛАНДО PRO — ПОРТАЛ ОБЪЯВЛЕНИЙ И УСЛУГ
SLANDO PRO — современная доска объявлений и универсальный портал для поиска товаров, услуг, недвижимости и вакансий. Публикуйте объявления бесплатно и находите нужное легко! Подходит для частных лиц и бизнеса в России, Украине и других странах СНГ.

